Grok 4.7 在 2026 年 9 月 21 日上线,定位不是涨价后的新旗舰,而是同一张价目表上的更大模型。Cursor、Grok Build、Grok 应用和 xAI API 都能用。SpaceXAI 公布的对比里,它相对 Grok 4.6 每一项都有提升,对 GPT-5.6 Sol 赢了七项里的五项,但 Claude Fable 5.1 仍领先最关键的编码和长任务榜。国内开发者更该关心的是另一件事:这个模型会不会成为 Cursor 里更稳的默认选项,以及它会不会改变你该买 Pro、Pro+ 还是 Ultra。
这次到底更新了什么
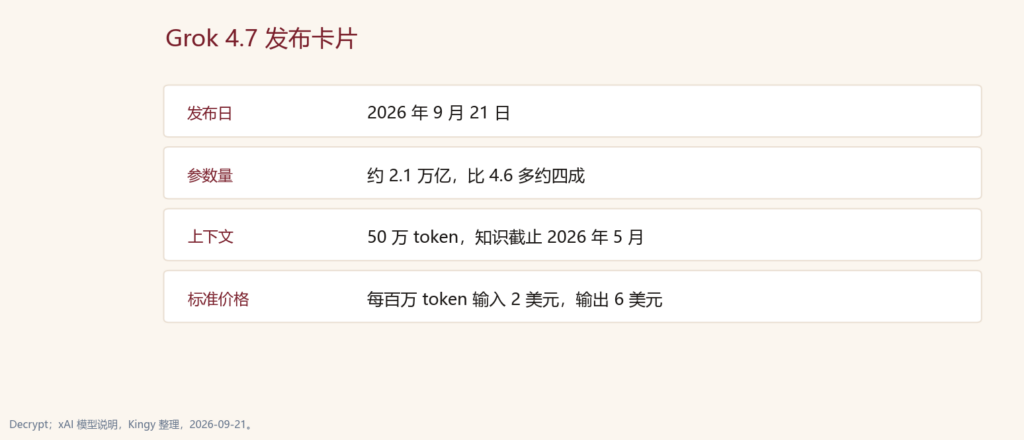
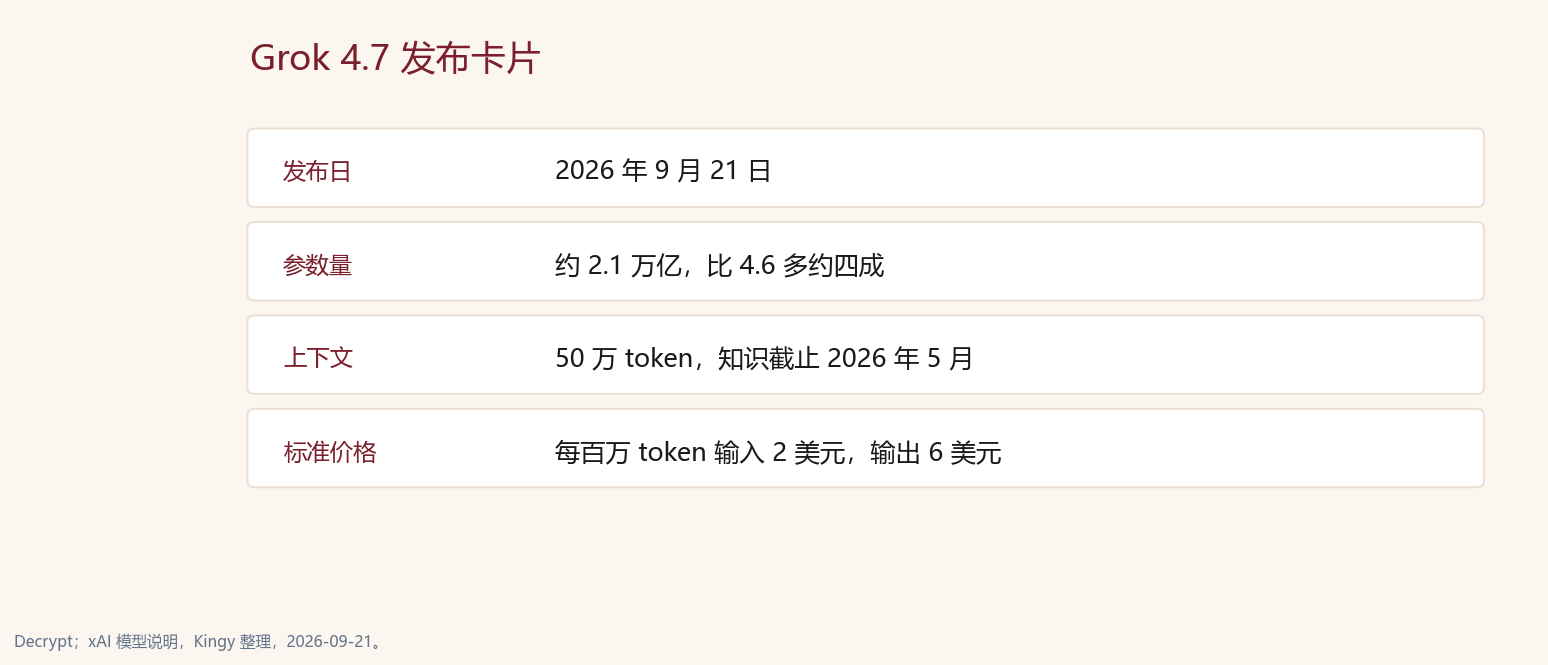
Decrypt 报道参数量约 2.1 万亿,比 Grok 4.6 的 1.5 万亿大约多四成。标准价格没有动。提示词低于 20 万 token 时,每百万 token 输入 2 美元,缓存输入 0.50 美元,输出 6 美元。一旦达到或超过 20 万 token,整次请求改按输入 4 美元、缓存 1 美元、输出 12 美元计费,不是只对超出的那一段加价。
Kingy 根据 xAI 模型说明整理的规格是:上下文 50 万 token,知识截止日期 2026 年 5 月,输入支持文本和图像,输出只有文本。它不会直接生成图片或视频。推理档位从 low 到 xhigh,默认是 high,而且不能把推理关掉,所以一句很短的回答仍可能为思考 token 付费。
官方对能力的说法是:更大的基座、更长的强化学习,训练任务偏向要花数小时才能做完的题,并且更频繁地检查自己的输出。Decrypt 还提到补充了 SpaceX 的工程数据,包括 Starlink 遥测、制造记录和故障日志。这可以解释电气工程分数为什么跳得特别多,但不能当成「它已经是硬件工程师」。
基准表:哪些分值得看
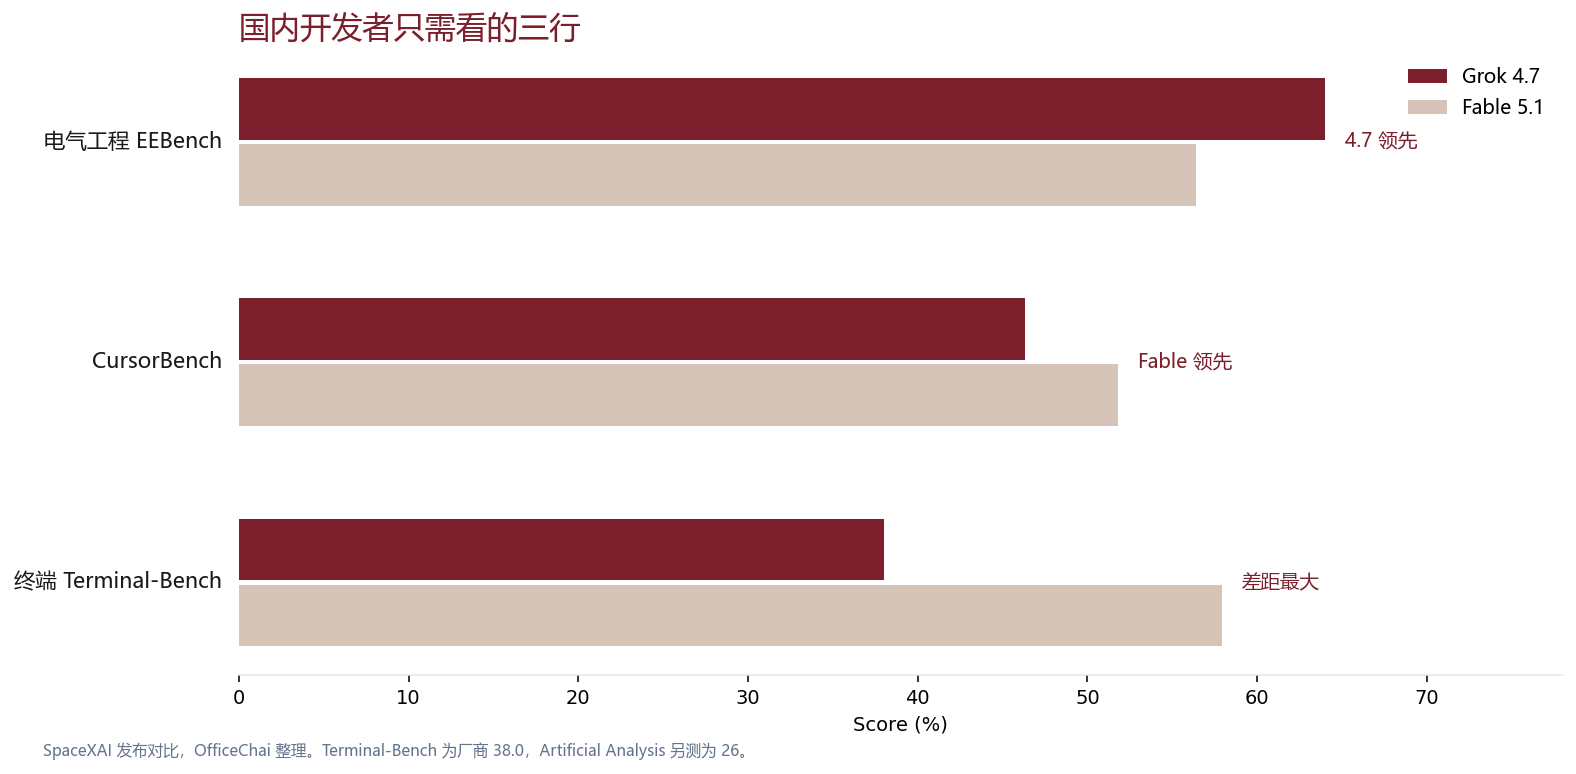
下面的数字来自 OfficeChai 对 SpaceXAI 发布对比的整理。Grok 4.7 多数项目用的是 xHigh,DeepSWE 例外,用的是 high。Grok 4.6 是 High,GPT-5.6 Sol 和 Fable 5.1 是 Max。档位不完全一样,一分以内的差距当成噪声。
| 基准 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
| AA-Briefcase Elo | 1657 | 1546 | 1487 | 1678 |
| Harvey 法律代理 | 19.6% | 15.8% | 2.5% | 6.7% |
CursorBench 是 Cursor 用户最该看的一行,也是最该保留怀疑的一行,因为它是 Cursor 自家的编码基准。46.3% 明显高于 4.6 的 40.4%,也高于 Sol 的 41.7%,但仍低于 Fable 的 51.8%。SpaceXAI 的价格性能曲线把大约 46% 的成绩标在每任务 6 美元附近,Fable 的 51.8% 则在大约 17 美元。这是读图,不是账单。
EEBench 是最干净的胜利:64%,高于 Fable 的 56.4% 和 Sol 的 39.4%。做电路、电源或硬件调试的人,这是少数值得把默认模型换成 Grok 的领域。
Harvey 容易被截图误用。19.6% 确实高于 Fable 的 6.7% 和 Sol 的 2.5%,但绝对分仍然很差。赢的是一场大家都没做好的测试,不是律师执照。
终端长任务是短板。厂商自己的 Terminal-Bench 是 38.0%,几乎是 Grok 4.6 的两倍,但仍比 Fable 的 57.9% 低了将近 20 个点。独立机构 Artificial Analysis 的同名测试更低,只有 26%,Fable 55%,GPT-6 Astra 60%,甚至 DeepSeek V4.1 Flash 也有 27%。两套数字不要平均成一个「真实分数」。结论只有一句:要在终端里连续调用工具好几个小时的活,Grok 4.7 还不是第一选择。
文书和知识工作几乎追平
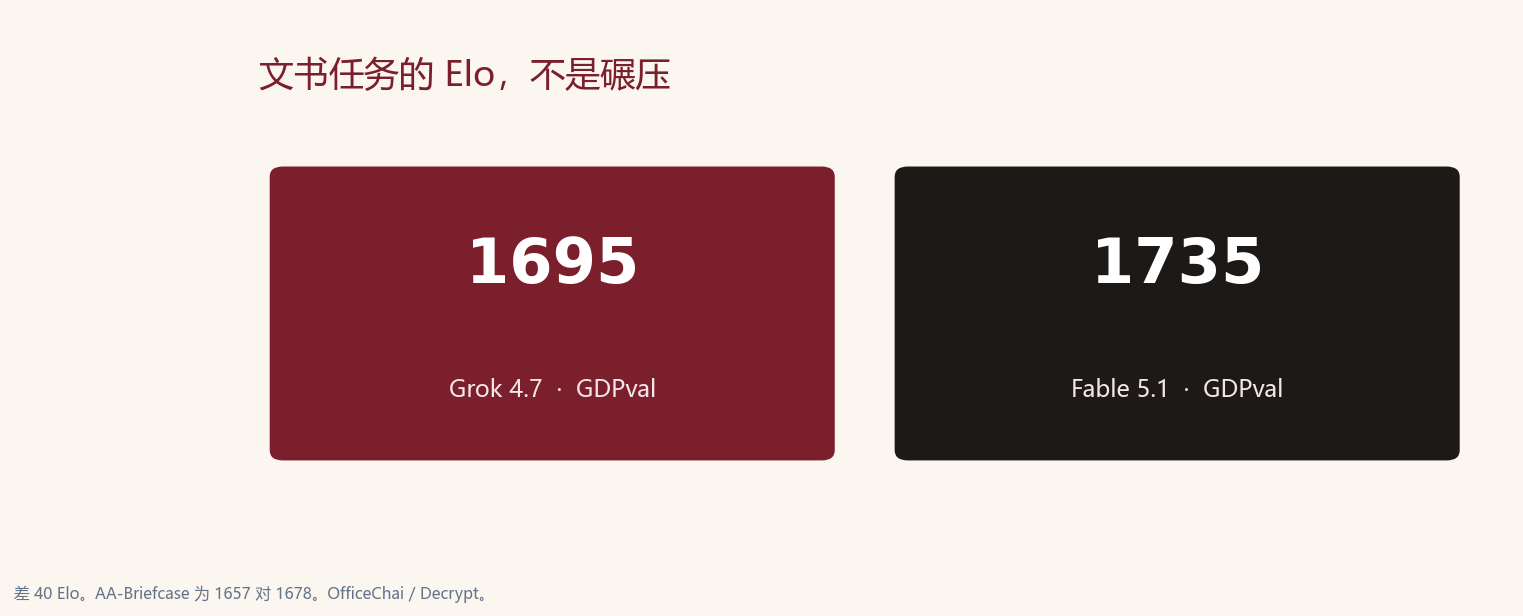
GDPval 用 Elo 给真实职业任务打分,例如备忘录、表格和幻灯片。Grok 4.7 是 1695,Fable 5.1 是 1735,Grok 4.6 是 1605。更新的 GPT-6 Astra 在这张图上是 1542,低于 4.7。AA-Briefcase 测的是长达数小时的办公室任务,Grok 4.7 为 1657,Fable 为 1678。差 21 分 Elo,算排名差距,不算换代差距。
Artificial Analysis 的综合指数 v4.3.2 没有这么客气:Grok 4.7 是 46,Fable 5.1 和 GPT-6 都是 53。high 和 xhigh 两个最高推理档得分一样。把努力档拉满,不会在这张综合榜上变成另一个模型。Musk 在发布前已经把预期放低,称 4.7 大致对标 Claude Opus 5.0,而不是更新的 5.1,多模态仍要补。公开成绩和这句话是对齐的。
价格才是和对手拉开的地方
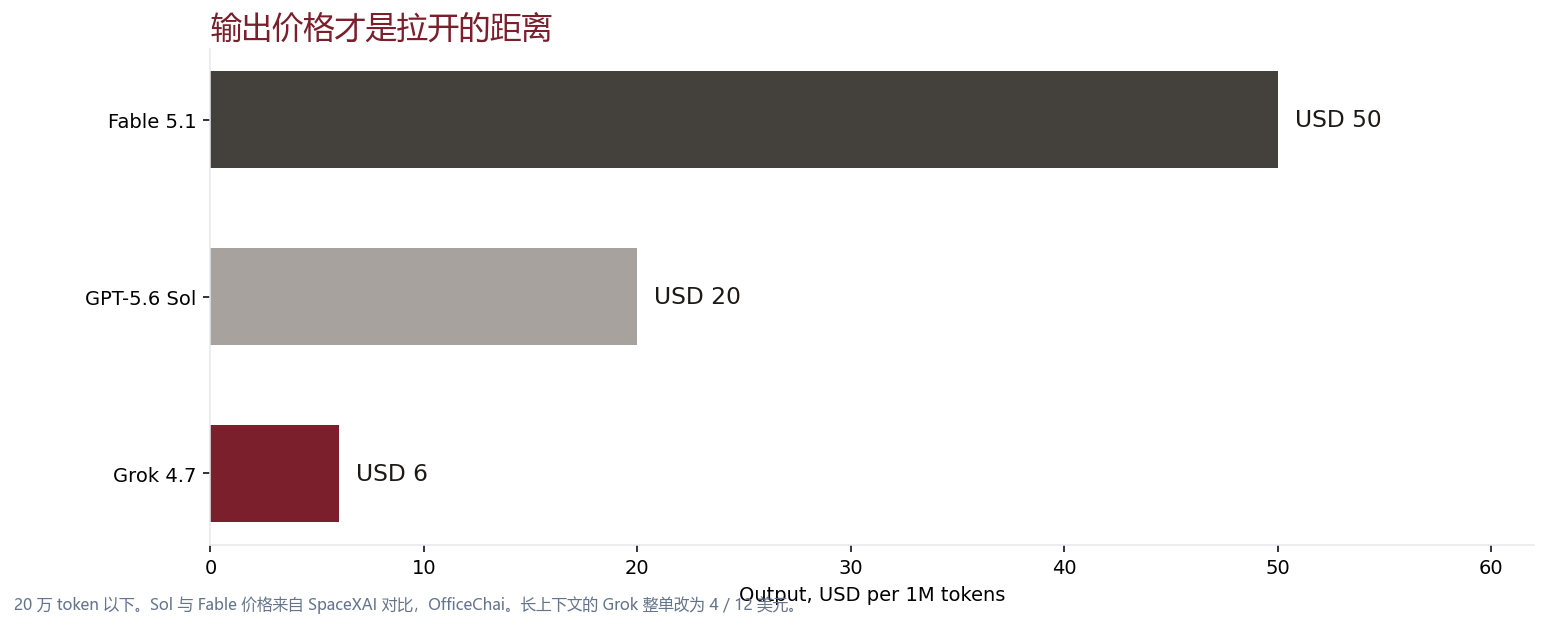
OfficeChai 引用的对比价是:GPT-5.6 Sol 每百万 token 输入 4 美元、输出 20 美元;Fable 5.1 输入 10 美元、输出 50 美元。Grok 4.7 仍是 2 美元和 6 美元。输出价格大约是 Sol 的三分之一以下,大约是 Fable 的八分之一。
Cursor 和 Grok Build 里还有 Fast 档,官方说法是输出速度大约翻倍,短上下文价格也大约翻倍,即输入 4 美元、输出 12 美元。Fast 不在公开 API 上,Grok Build 的免费入口也不包含它。交互时开着等结果可以,后台代理整天开着 Fast,便宜模型就不便宜了。
Kingy 给了一个更接近真实账单的算法。5 万输入加 5 千输出,大约 0.13 美元。同样的形状跑十轮,工具费另计,大约 1.30 美元。把稳定前缀命中缓存后,单轮可以降到大约 0.07 美元。25 万 token 的长提示会掉进高价档,配 1 万输出大约 1.12 美元。比模型时要比完成一个任务的总请求数,不要比首页上的「2 美元」。
在 Cursor 里怎么选计划
xAI 的可用性说明写的是:所有 Cursor 计划都能在模型选择器里看到 Grok 4.7。看得到不等于不限量。Pro 每月 20 美元,附带 20 美元第三方 API 额度。Pro+ 每月 60 美元,附带 70 美元额度,Agent 限额约为 Pro 的 3 倍。Ultra 每月 200 美元,附带 400 美元额度,Agent 限额约为 Pro 的 20 倍。Cursor 自有模型池原先覆盖 Grok 4.6、Grok 4.5 和 Composer 2.5,和这桶美元额度是分开的。跑完一次 4.7 之后看用量面板,确认动的是哪一桶,不要猜。
国内网络还有一层和模型聪明程度无关的限制。Cursor 按出口 IP 做区域判断,人在中国大陆或香港时,即使已经付费,Claude、GPT 一类模型仍可能提示 This model is not available in your region。Grok 成为默认模型,有时不是因为它榜单第一,而是因为另一组模型根本调不通。代理要走 TUN 或全局模式,尽量不要用香港节点,并在设置里写入 http.proxy、http.proxySupport 为 override,以及 cursor.general.disableHttp2 为 true,然后完全重启 Cursor。付费成功不等于模型可用,这两件事要分开排。
计划本身按用量选,不要按发布会选。日常补全加少量 Agent,Pro 就够。每天让 Agent 干活、但多数请求已经改到 Grok 4.7 或 Composer 2.5 Standard(每百万 token 输入 0.50 美元、输出 2.50 美元),Pro+ 通常更划算。只有第三方模型用量稳定超过大约 210 美元时,官方 200 美元的 Ultra 才比 Pro+ 加超额更便宜。新模型越能接住日常任务,Ultra 越难论证,而不是越该买。
如果你已经确认这个月会打满额度,只想先用一个月 Ultra 看新模型的实际消耗,可以看我们的 Cursor Ultra 1 个月个人账号激活,149 美元,含 1 个月质保。这是独立激活服务,与 Cursor Inc.、Anysphere、xAI 没有官方关系。Cursor 自己的订阅只在 cursor.com 出售。用量如果每月不到 100 美元,就留在 Pro+,不必因为发布日升级。
本周该不该把默认模型换掉
如果你现在用的是 Grok 4.6,换成 4.7 标准档。价格相同,公布的各项成绩都更好。如果你的失败模式是终端里的长代理任务,默认模型继续留在 Fable 或同级前沿模型上,两家评测的具体百分比不一样,排名一样。硬件和电气类问题可以优先试 4.7。医疗文书不要因为这次发布就换过去。
先在分支上给它一个你已经理解的失败测试:找到原因,做最小修改,跑相关测试,解释改了什么。和你现在的默认模型用同一批文件比一次。记下过不过、你改了多少、用量面板动了哪一桶。这比转发一张榜单有用。
常见问题
Cursor 的每个套餐都能用 Grok 4.7 吗?
按 xAI 发布日的可用性说明,所有计划的模型选择器里都有,并且提供 Fast。包含的用量仍由套餐决定。选中之后跑一个真实任务,再看用量,而不是假设这次请求免费。
比 Grok 4.6 贵了吗?
标准价没变,仍是每百万 token 输入 2 美元、输出 6 美元。20 万 token 及以上的请求整单改为 4 美元和 12 美元。Fast 是另一档更高的价格。
它能生成图片吗?
不能。它接收图像,只输出文本。图像和视频是 xAI 的其他产品。应用里同时出现这些功能,不代表它们是 Grok 4.7 的输出。
为什么 Terminal-Bench 有 38% 也有 26%?
38.0% 是 SpaceXAI 自己的数字。26% 是 Artificial Analysis 的独立跑分。引用时带上来源。两份材料都显示 Fable 和 GPT 的前沿模型在这项上领先。
选择器里没有 Grok 4.7 怎么办?
先更新 Cursor,确认账号和网络,再看模型列表。API、Build 和旧版客户端不会在同一分钟刷新。客户端外的模型 ID 是 grok-4.7。区域报错时,先处理代理和 HTTP/2,而不是反复换套餐。
资料来源
- Decrypt,2026 年 9 月 21 日:参数量、GDPval、上线范围。
- OfficeChai:厂商基准表和价格对比。
- The Decoder:Artificial Analysis 综合指数和独立 Terminal-Bench。
- Kingy:上下文、价目、Fast 限制、Cursor 可用性。